Agent多人共用为何会失控?来自Ankole的Business Agent架构设计分享
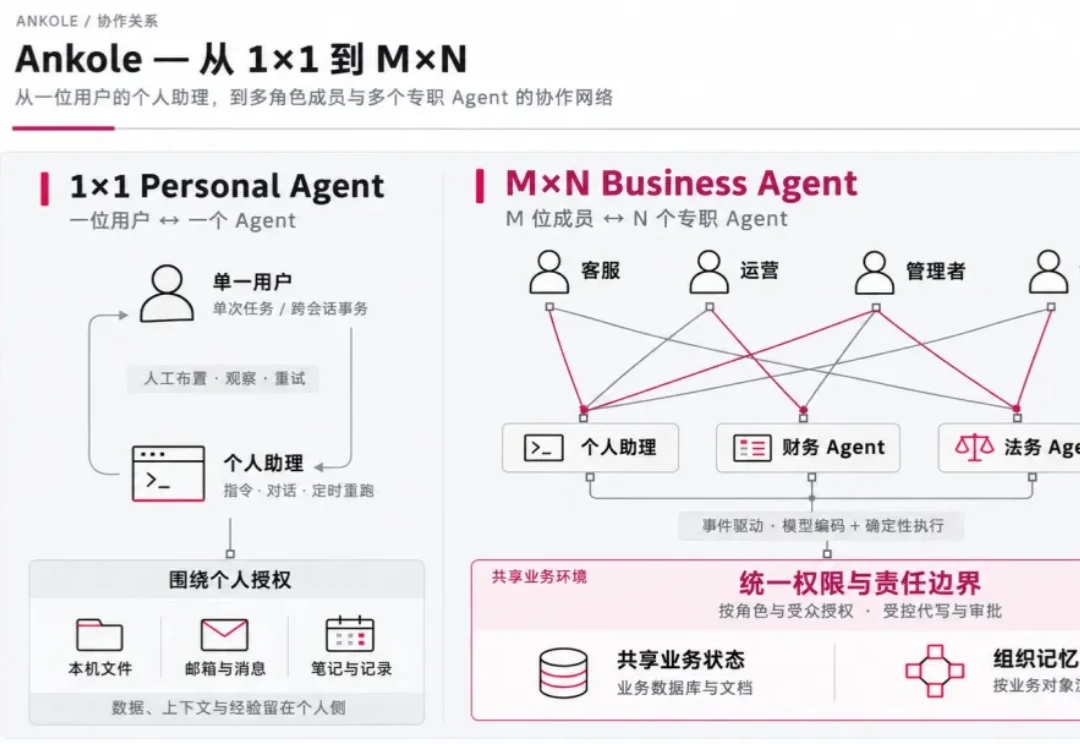
Agent多人共用为何会失控?来自Ankole的Business Agent架构设计分享继 Coding Agent 之后,Muse、Grok Bot 等 Personal Agent 产品也快速成熟。不少团队尝试把它们引入组织:要么给每位成员部署一套,要么把同一个 Agent 接进部门群聊。但单人使用表现稳定的 Agent,一旦放到多人协同场景总是表现得非常不及预期。
搜索
继 Coding Agent 之后,Muse、Grok Bot 等 Personal Agent 产品也快速成熟。不少团队尝试把它们引入组织:要么给每位成员部署一套,要么把同一个 Agent 接进部门群聊。但单人使用表现稳定的 Agent,一旦放到多人协同场景总是表现得非常不及预期。
最近,在Neo4j的NODES 2026中,联合创始人兼CEO Emil Eifrem作为主持人问吴恩达:过去一年Coding Agent变化这么大,AI工程师到底还需要学什么?
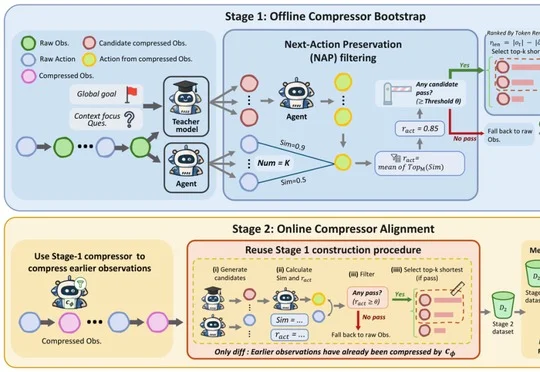
清华大学人工智能学院提出面向 Coding Agent 的 observation 压缩方法 CoACT,在 SWE-bench Verified 的三个 Agent 模型上平均减少 33.0% 总 token 消耗且 PASS@1 与未压缩时相近,该工作获 ICSE 2027 直接接收(Top 5%)。
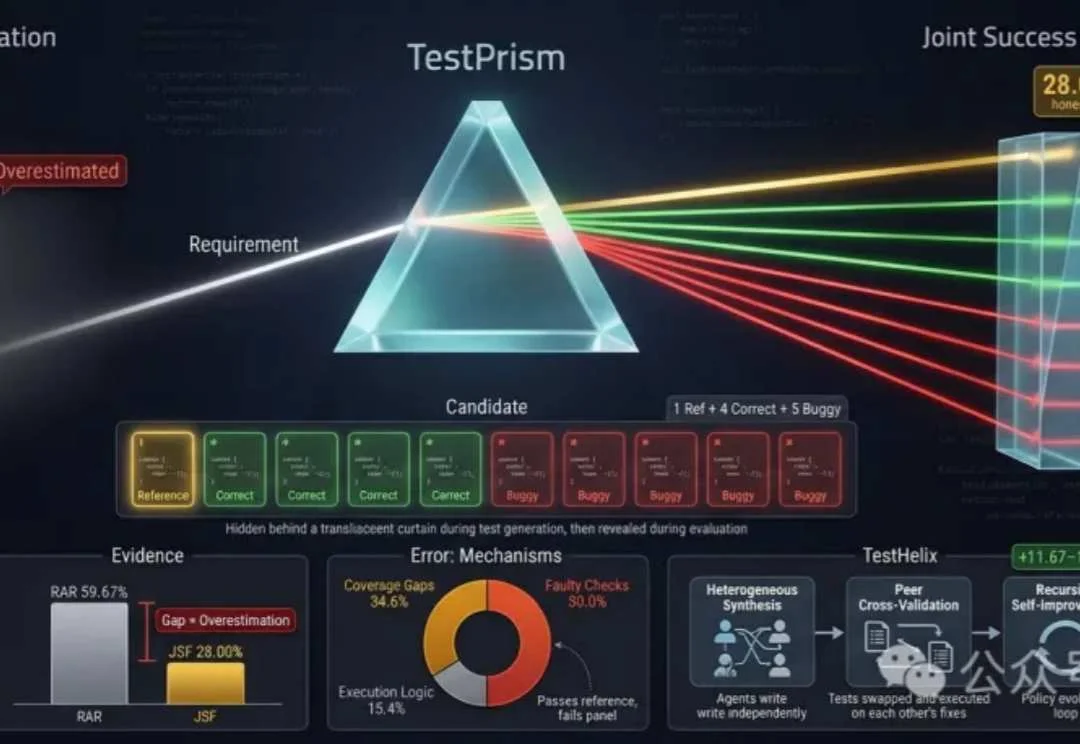
Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
Ben:Agent碰到障碍,会继续尝试,直到把任务做完。它不会告诉你中途哪里失败过,最后只会说:已经完成了。
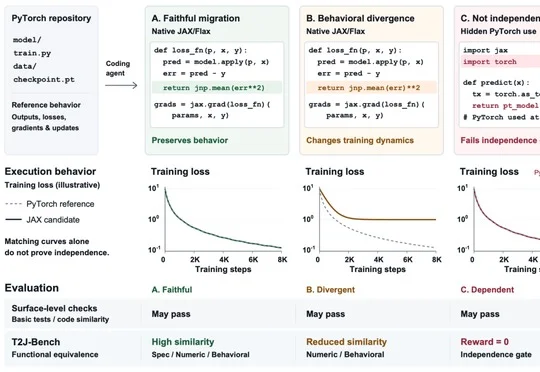
Google Cloud AI Research等团队发布T2J-Bench,以63个整仓任务评测Coding Agent将PyTorch迁移至JAX的行为保真度,并提出TwinHarness,使Claude-Code与opus-5组合的总体得分从0.649升至0.723,相对提升11.4%。
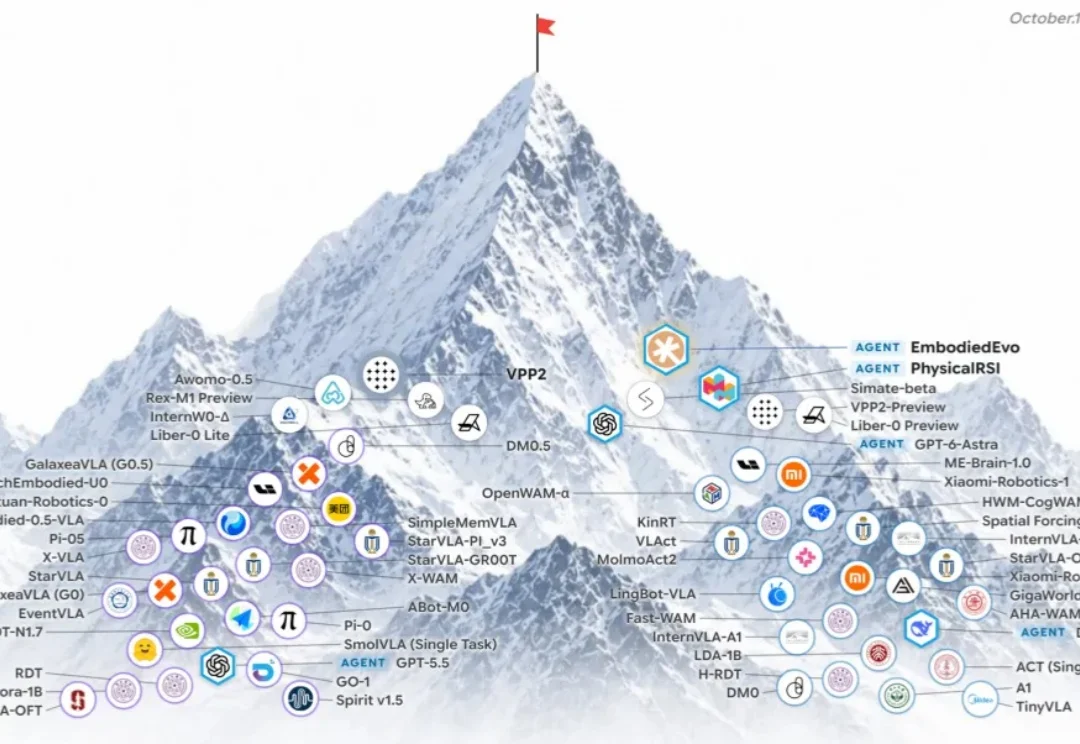
近期,六角未来沿着 Physical Coding 的思路,进一步构建了 HexaShell-Preview。根据官方评测结果,在 RoboDojo 全部 42 项任务上,HexaShell-Preview 取得了 46.9% 的成功率、53.2 的进度得分,成功率高出第二名 7.5 个百分点,领跑 RoboDojo-Agent 榜单。
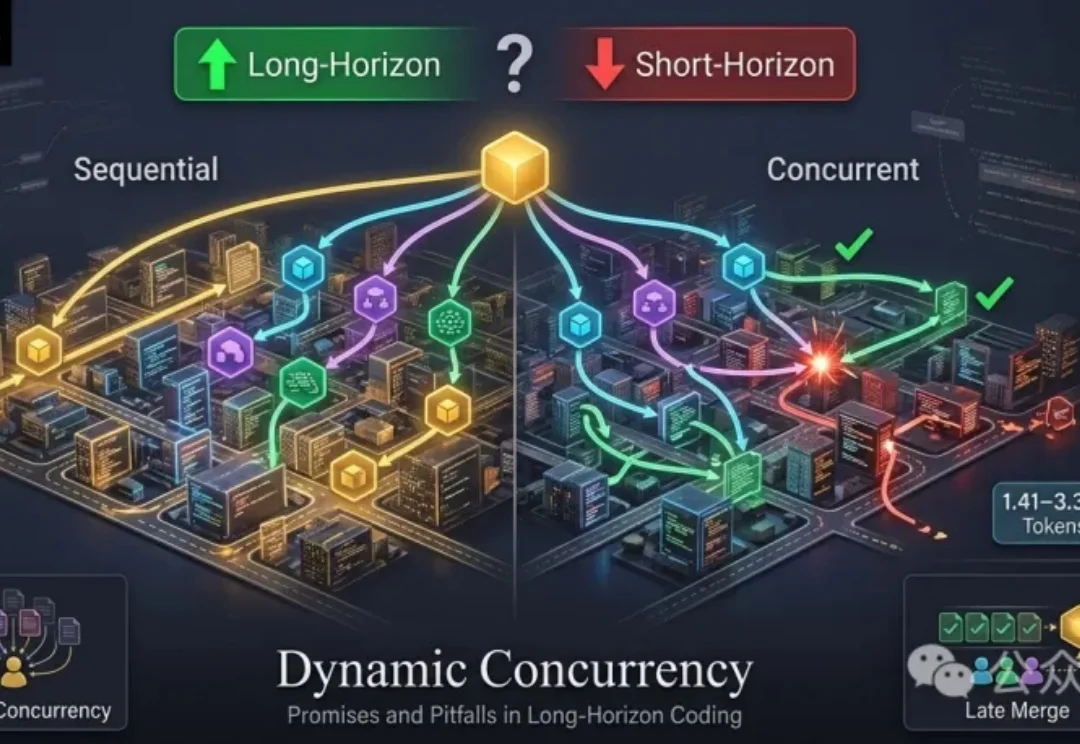
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
会写代码的 Agent,正在走向物理世界。
欧洲开发者 Mario Zechner 开发的极简 Coding Agent Harness Pi 只给模型一个 bash,却在多项 Benchmark 中击败 Claude Code 和 Codex,凭借极简设计和高可扩展性在 2025 年底爆火,团队来自维也纳而非硅谷。